極點宏觀|Financial Cloud Cloud · 挑戰
週末 Agent 挑戰:上午 6 點交易風險審查
應用程式或儲存庫連結
原始碼: https://github.com/dchan-dev/aws_morning_trading_review_mail
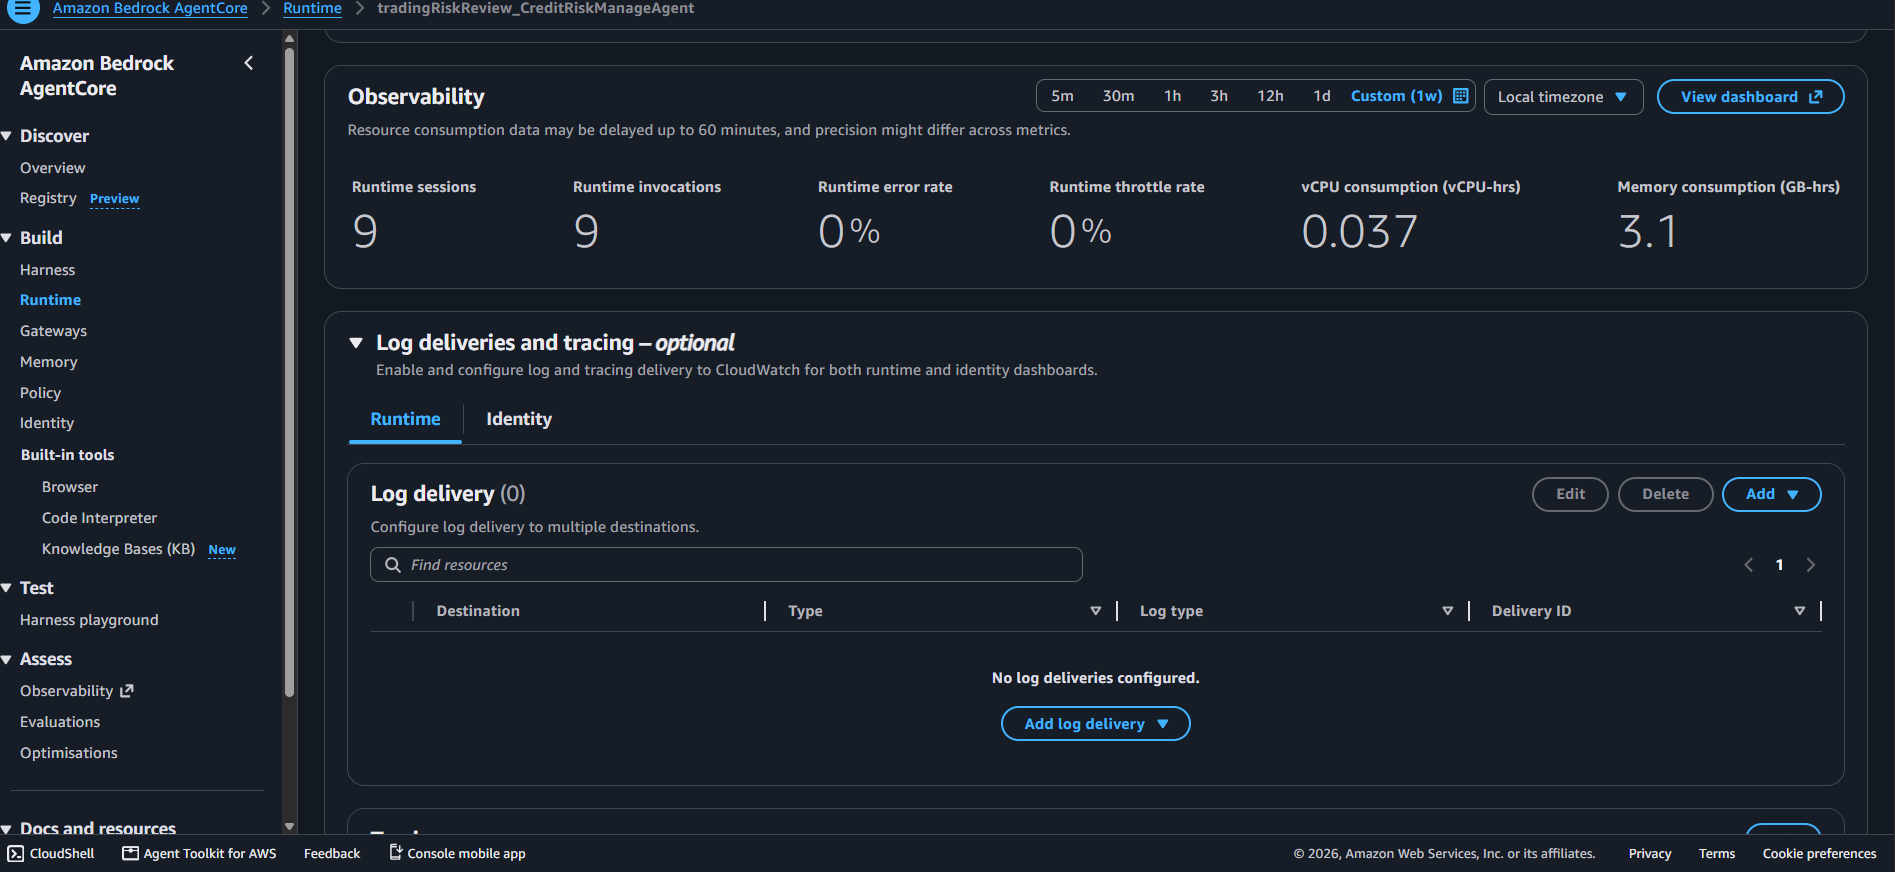
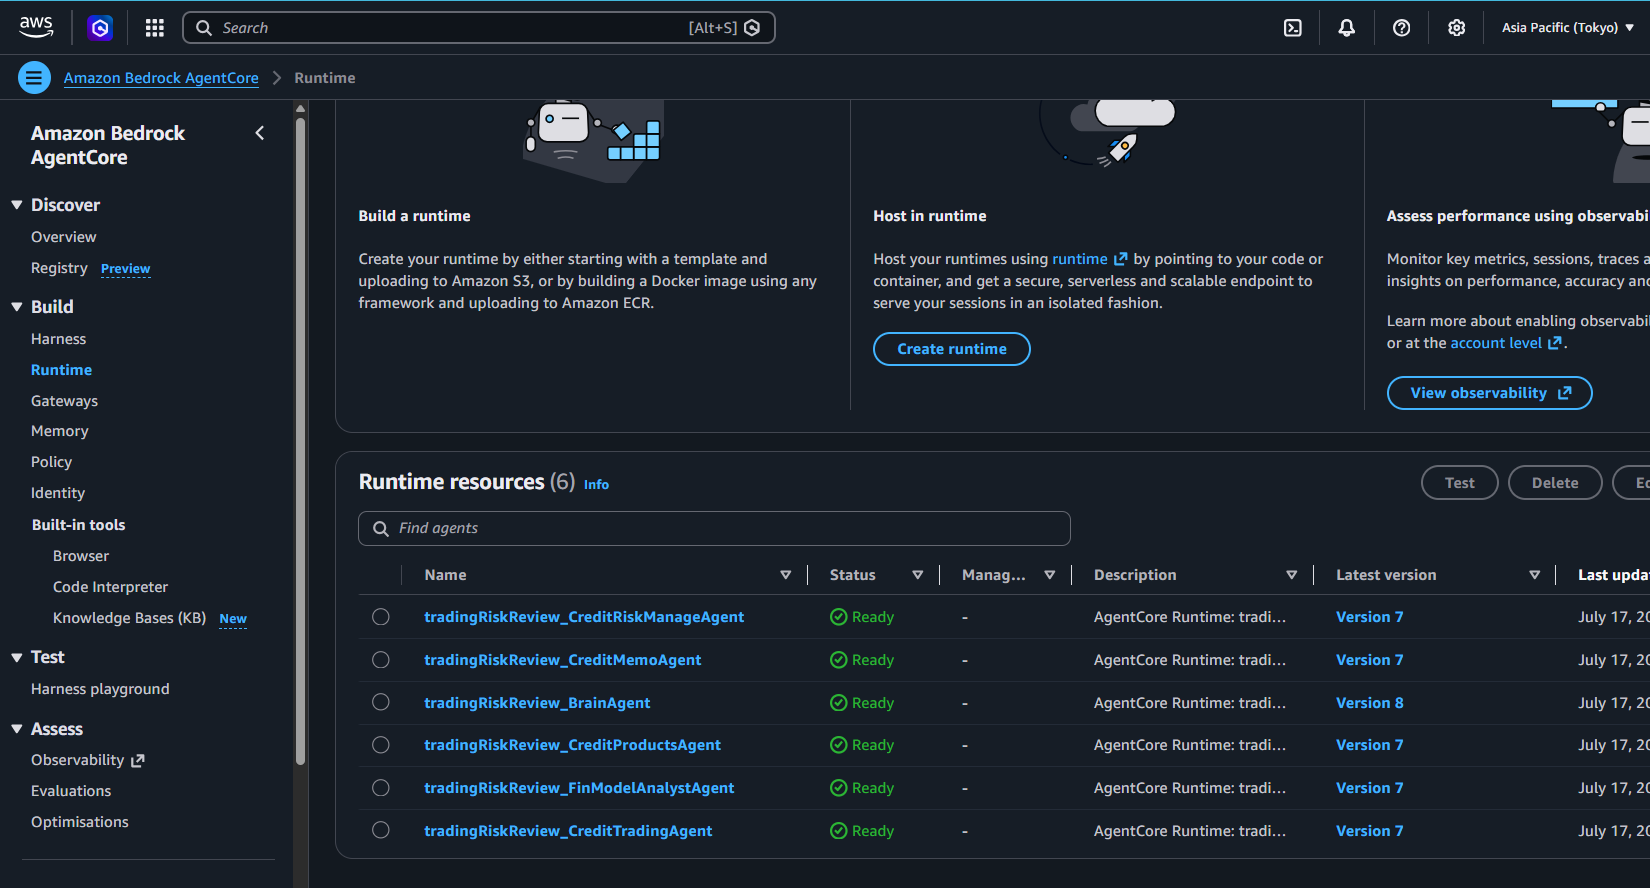
六個執行階段包分別是 BrainAgent、CreditMemoAgent、CreditProductsAgent、CreditRiskManageAgent、CreditTradingAgent 和 FinModelAnalystAgent。
最好的演示不是一個聊天視窗,而是一串安靜但可驗證的證據:排程器在 06:00 觸發,六份研究產物出現在 S3 中,一份風險簡報在交易員開口詢問前送達。到了這個時刻,Agent 才不再只是一個有趣的提示詞,而開始成為一個系統。
詳情
每天早上 6:00,在宏觀交易臺開盤之前,一個事件會啟動一條研究工作流。它不像聊天機器人,更像一個小型的虛擬信用委員會。
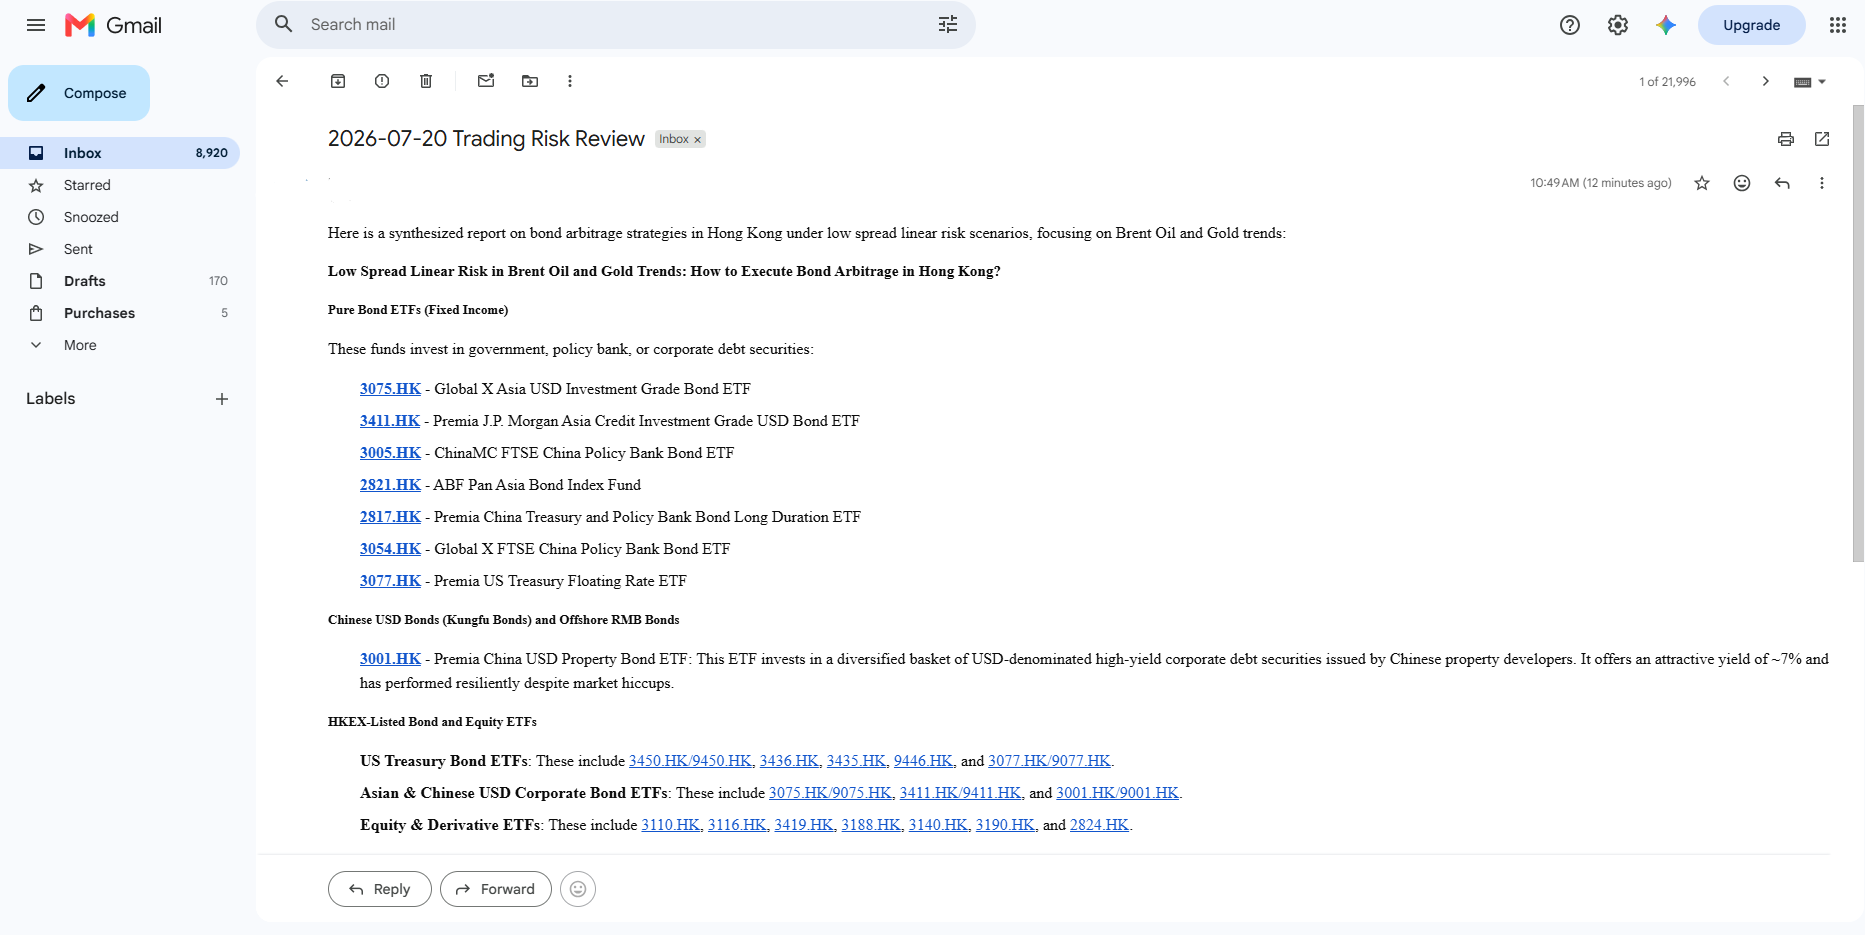
它收集當前市場證據,讓五個專家 Agent 從不同專業視角審查同一個風險問題,再由 Brain Agent 質疑並綜合它們的結論,把研究軌跡儲存在 Amazon S3 中,並透過電子郵件傳送晨間報告。分析師不需要登入系統、複製提示詞,也不需要守在瀏覽器旁邊等待。
最後這一點是這個專案的核心:有用的工作會在沒有我介入的情況下完成。
本專案是一個研究和決策支援演示。它不執行交易,不發放信貸,也不替代經授權的風險、合規或投資專業人員。
願景與 Agent 的工作內容
宏觀交易員一天中的第一個小時成本很高。隔夜利率、匯率、大宗商品、主權利差和企業信用的變化,必須在流動性和市場注意力轉移之前轉化為倉位觀點。普通新聞摘要並不夠。交易臺需要知道:
● 發生了什麼變化?
● 這次波動是由增長、通脹、流動性、償付能力、政策、倉位還是技術性資金流驅動的?
● 它如何傳導到主權債、企業信用、外匯、大宗商品和融資市場?
● 哪些資訊已經被定價?
● 在考慮融資、對沖、流動性和執行成本之後,哪個倉位具有更好的 carry 和凸性?
● 哪個可觀察訊號會推翻這個觀點?
6 AM Trading Risk Review 將這個過程變成了一條事件驅動的 Agent 工作流。
Amazon EventBridge Scheduler 會在交易臺設定的時區 06:00 呼叫一個小型 AWS Lambda 函式。Lambda 將一個有邊界的早間審查請求傳送給執行在 Amazon Bedrock AgentCore Runtime 上的 Brain Agent。Brain Agent 再把同一個問題委派給五個獨立的專家執行階段:
| Agent | 機構角色 | 主要貢獻 |
|---|---|---|
| CreditRiskManageAgent | 信用風險經理 | PD、LGD、EAD、預期損失、評級遷移、限額、契約、集中度和壓力損失 |
| FinModelAnalystAgent | 基本面信用分析師 | 現金流標準化、槓桿、流動性跑道、償債能力、蒙特卡洛和反向壓力測試 |
| CreditProductsAgent | 產品結構師 | 融資條款、抵押品、受償順位、擔保、CDS 機制、交易對手風險和剩餘產品風險 |
| CreditTradingAgent | 信用交易員 | 現券/CDS 基差、相對價值、carry、roll-down、流動性、市場衝擊、對沖規模和失效水平 |
| CreditMemoAgent | 信用核准備忘錄起草助手 | 證據臺賬、重大風險、緩釋因素、例外、條件和可供審閱的決策記錄 |
Brain Agent 不是第六個簡單投票的意見。它是編排者。它的提示詞從風險環境和政策反應函式開始,比較專家之間的分歧,並把它們的發現轉化為一份受治理的晨間簡報:市場環境、證據、組合影響、候選行動、對沖、確認訊號和失效觸發條件。
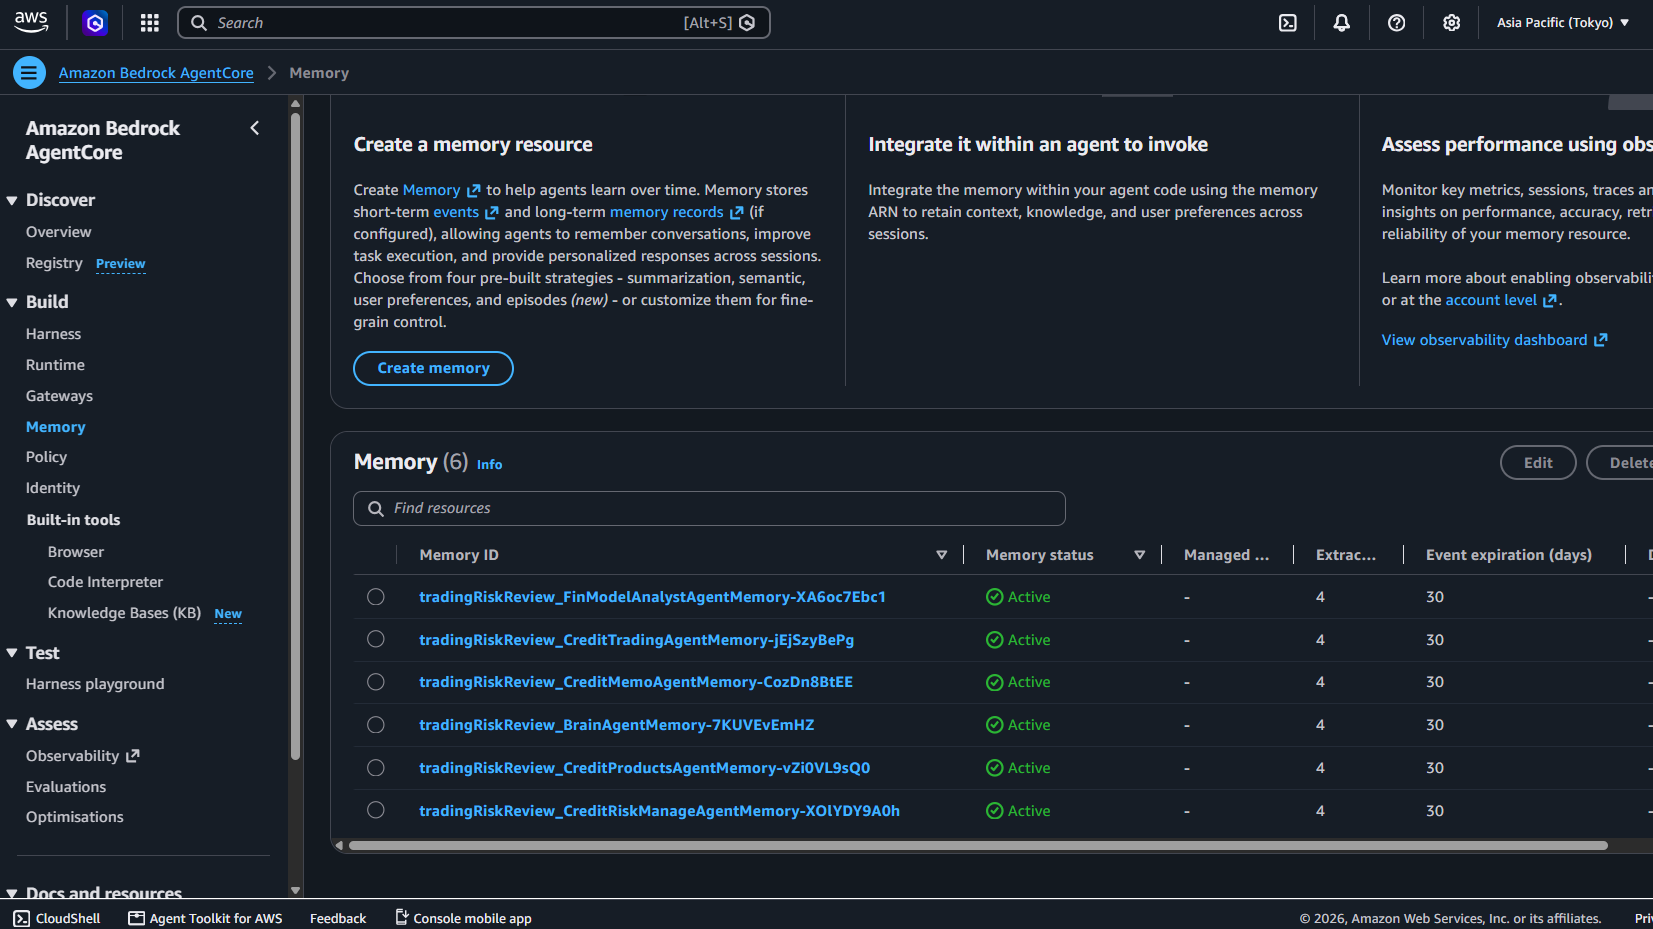
每個專家都有自己的領域提示詞和 AgentCore Memory。記憶設定將語義事實、使用者偏好、會話摘要和情景經驗分開。這樣系統可以記住交易臺希望如何表達風險,同時不會假裝昨天的市場事實今天仍然有效。
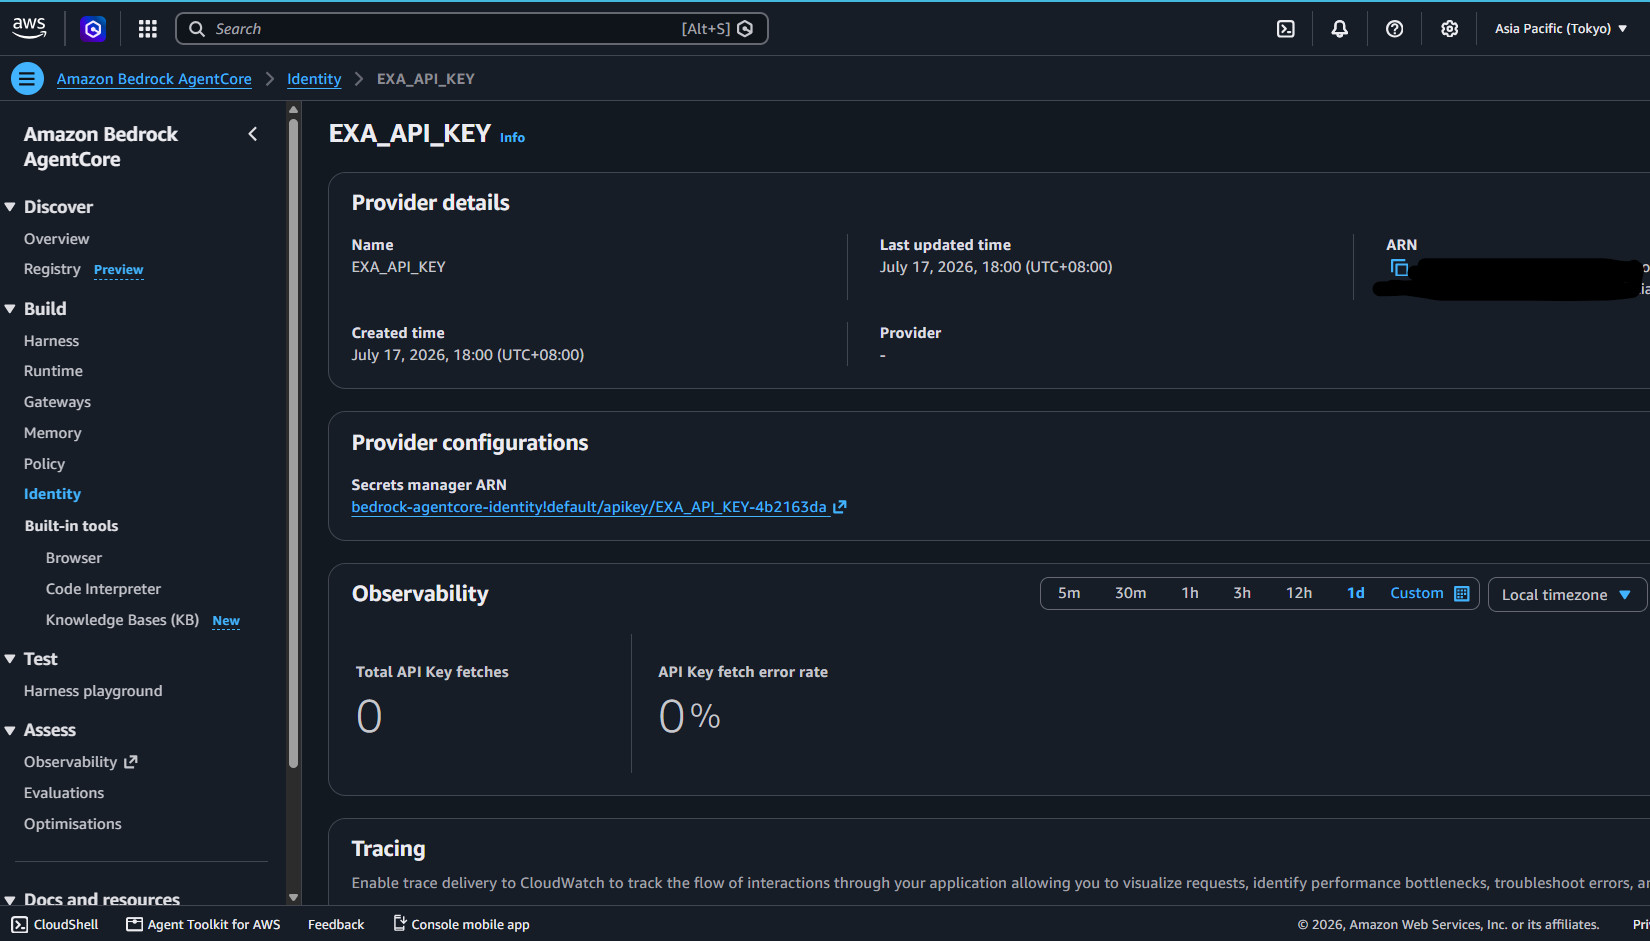
對於當前資訊,Agent 可以使用 Exa.ai 網頁搜尋。Exa API 金鑰 應該作為 API 金鑰憑證提供者放在 AgentCore Identity 中,而不是放在原始碼、Lambda 環境變數或提示詞裡。執行階段只在工具需要時才擷取憑證。搜尋證據和 Agent 輸出會寫入 S3,這樣最終建議可以追溯到每個專家看到的內容。
當最終的 Brain Agent 物件落到報告字首下時,一個 S3 ObjectCreated 事件會呼叫傳送 Lambda。該函式擷取報告,並透過 Amazon Simple Email Service(Amazon SES)傳送到宏觀交易員已驗證的郵箱地址。
交易員醒來時看到的是一份已經完成的審查,而不是一個提醒他開始審查的通知。
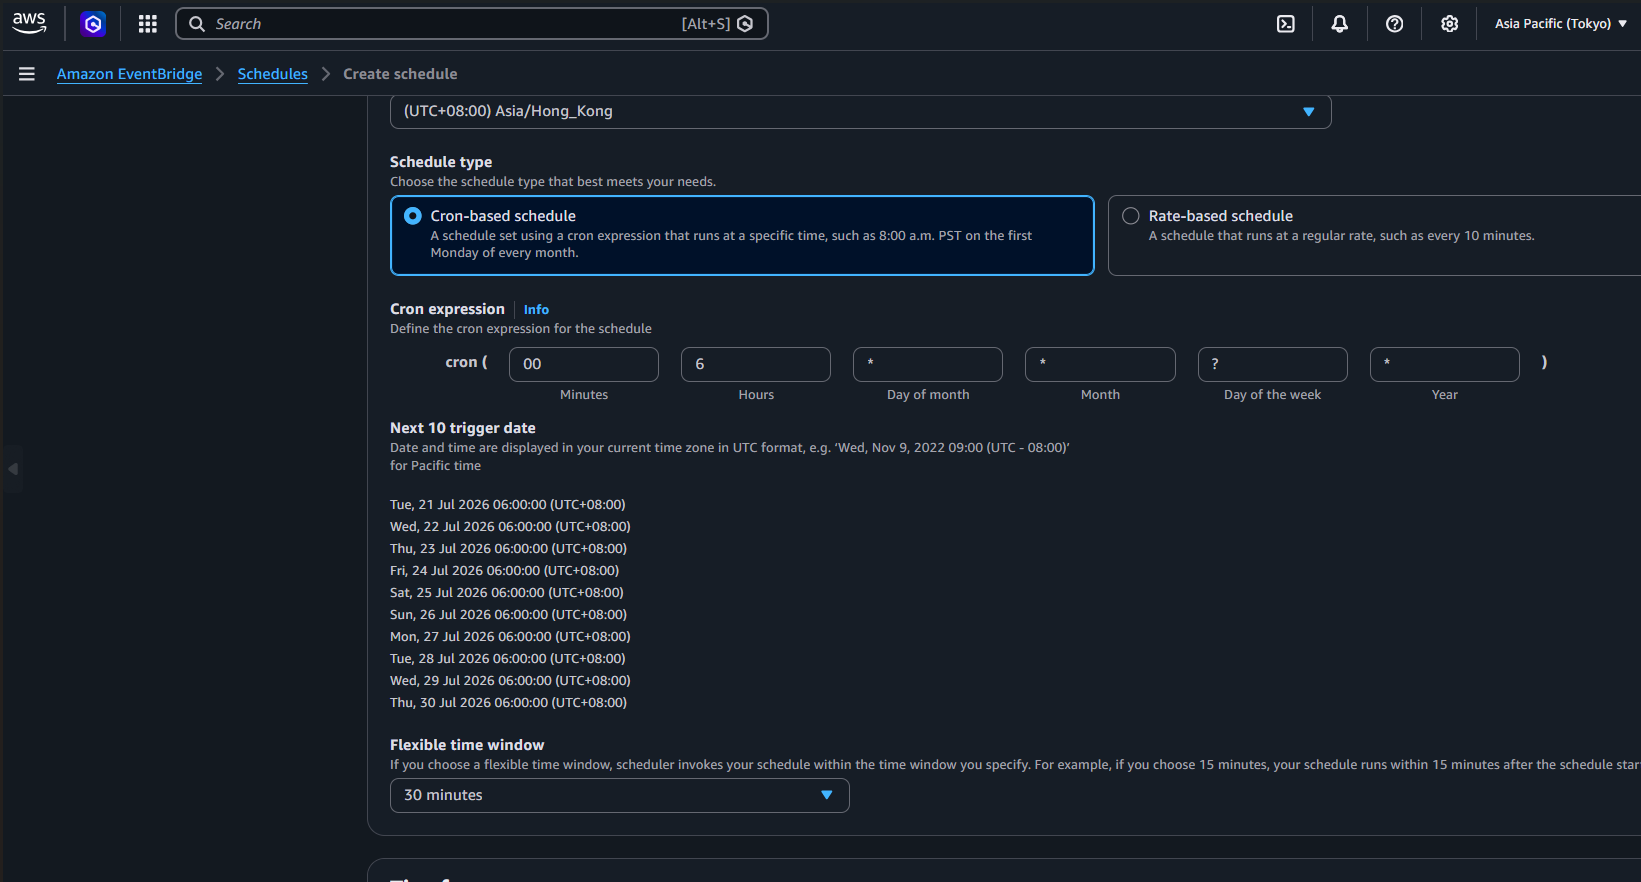
演示需要捕捉的證據: EventBridge Scheduler 在 06:00 成功呼叫、六個帶時間戳的 S3 產物,以及收到的 SES 晨間報告。這三張截圖可以端到端展示這條自主工作流。
你是如何構建它的
1. 我先建模交易臺,再選擇 Agent 拓撲
最重要的設計決策不是模型,而是專業視角的分離。在真實信用工作中,承銷、組合風險、產品結構、市場定價和核准檔案回答的是不同問題。把它們混在一起會產生熟悉但危險的類別錯誤。
因此,提示詞會編碼明確的金融恆等式和決策邊界:
Expected Loss = PD × LGD × EAD

Expected Net P&L =
  Spread Alpha + Carry + Roll-Down + Catalyst Value
  - Default Loss - Hedge Cost - Funding Cost
  - Transaction Cost - Liquidity Cost - Model Error
Credit Trading Agent 必須區分預測和可執行策略。Financial Modeling Agent 必須把宏觀衝擊連線到借款人的現金流,而不是套用表面化的百分比折減:
Macro shock → volume decline → margin compression → working-capital draw
→ covenant erosion → revolver use → refinancing dependence
→ liquidity event → default or restructuring
Credit Memo Agent 會保留來源衝突,而不是把它們平均成虛假的共識。重大核准仍然屬於負責的人員。這不僅是提示詞工程,也是控制設計。
2. 我將專家部署為獨立的 AgentCore 執行階段
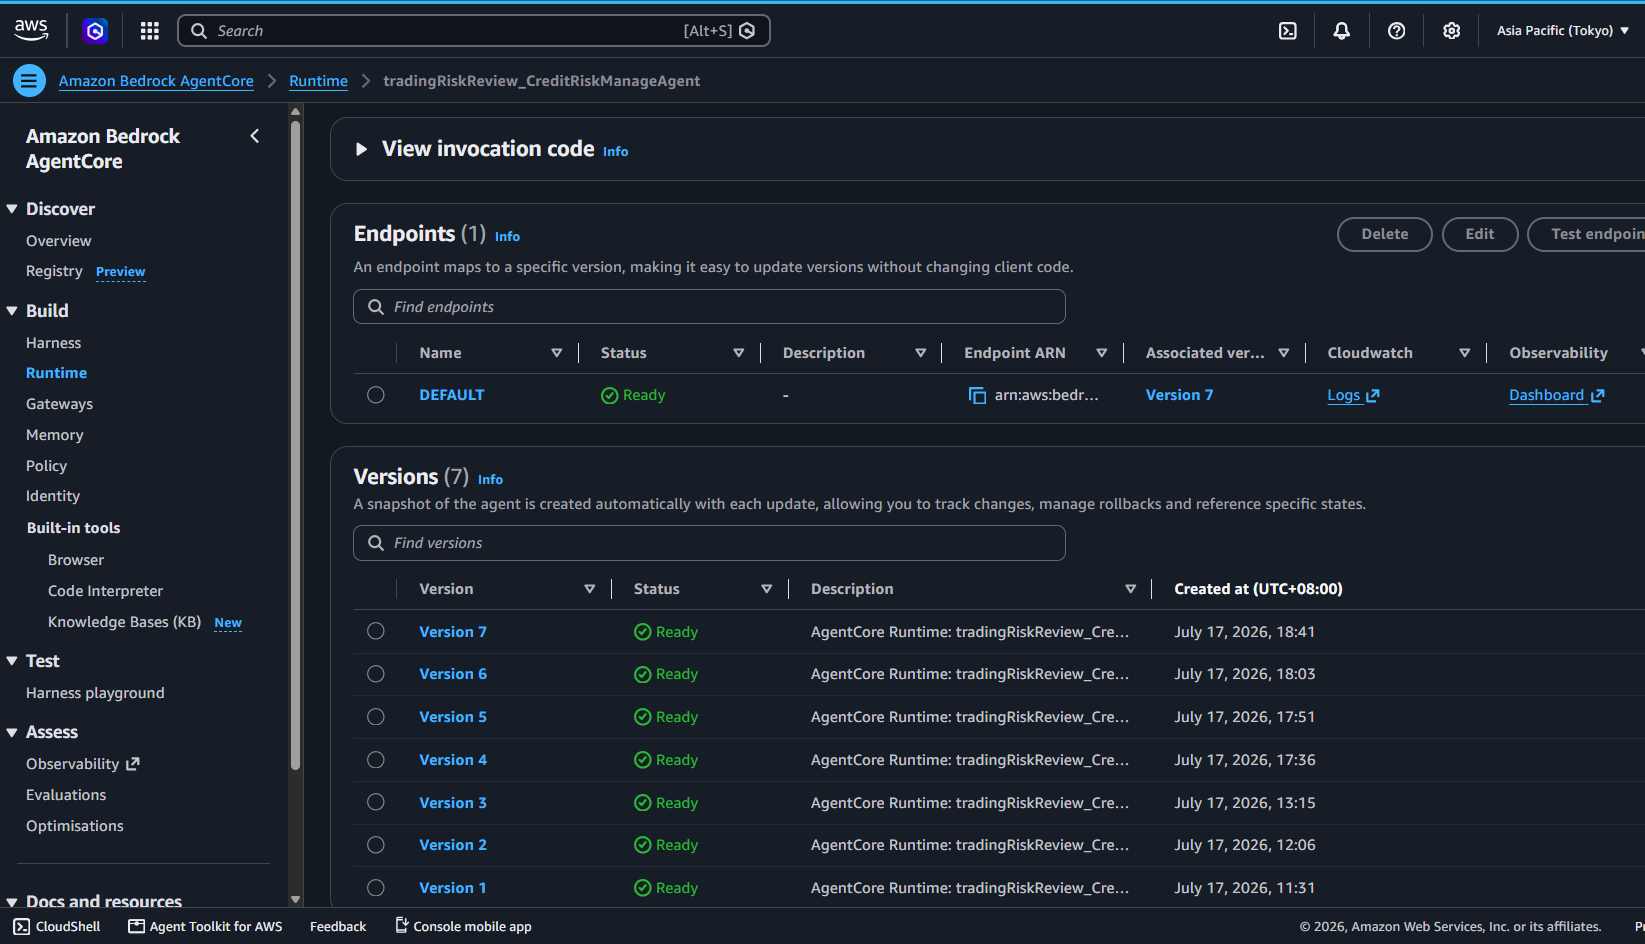
六個 Python Agent 都使用 Strands Agents,並作為 HTTP 執行階段執行在 Amazon Bedrock AgentCore 上。專案透過 CodeZip 打包,並透過 Amazon Bedrock 使用 Amazon Nova Pro 模型。
● 提示詞、記憶、相依套件和許可權可以獨立演進;
● 執行階段身分可以按角色收緊;
● 某個專家可以單獨測試或重新部署,而不影響其他專家;
● 故障會按專家顯現,而不是埋在一次很長的模型回合裡;
● 編排契約保持簡單:輸入提示詞,輸出有證據支援的 Markdown。
Brain Agent 透過 AgentCore 資料平面呼叫每個專家,收集流式響應,並把五個輸出注入到自己的綜合上下文中。當某個專家無法響應時,它也會記錄一個明確的失敗產物。
初始實現按順序呼叫專家。這是有意保持簡單、方便除錯的選擇,但由於五個審查彼此獨立,並行分發是下一步延遲最佳化。
程式碼講解:六個 AgentCore 應用內部
app 目錄有意保持一定重複。每個專家都是一個可獨立部署的應用:
app/
├── BrainAgent/
├── CreditMemoAgent/
├── CreditProductsAgent/
├── CreditRiskManageAgent/
├── CreditTradingAgent/
└── FinModelAnalystAgent/
<Agent>/
├── main.py # AgentCore 入口點、提示詞和工具
├── model/load.py # Amazon Bedrock 模型設定
├── memory/session.py # AgentCore Memory 會話介面卡
├── mcp_client/client.py # Streamable HTTP MCP 客戶端
├── pyproject.toml # 獨立執行階段相依套件
└── README.md宣告六個可部署執行階段
{
  "name": "tradingRiskReview",
  "runtimes": [
    {"name": "BrainAgent", "build": "CodeZip", "entrypoint": "main.py", "codeLocation": "app/BrainAgent/", "runtimeVersion": "PYTHON_3_14", "networkMode": "PUBLIC", "protocol": "HTTP"},
    {"name": "CreditTradingAgent", "build": "CodeZip", "entrypoint": "main.py", "codeLocation": "app/CreditTradingAgent/", "runtimeVersion": "PYTHON_3_14", "networkMode": "PUBLIC", "protocol": "HTTP"}
  ]
}
CodeZip 讓這個 Python 演示保持簡單:執行階段會打包原始碼和相依套件,而不需要應用程式容器。
載入一個受治理的模型設定
from strands.models.bedrock import BedrockModel


def load_model() -> BedrockModel:
    return BedrockModel(
        model_id="apac.amazon.nova-pro-v1:0",
        max_tokens=10000,
    )
這個工廠函式避免模型設定散落在編排程式碼中。10,000 token 上限是對專家報告在 4,000 token 處被截斷的實際回應。
構建通用 Strands 執行階段
app = BedrockAgentCoreApp()

tools = [add_numbers, exa, tavily, think]
tools.extend(client for client in mcp_clients if client)


def agent_factory():
    cache = {}

    def get_or_create_agent(session_id, user_id):
        key = f"{session_id}/{user_id}"
        if key not in cache:
            cache[key] = Agent(
                model=load_model(),
                session_manager=get_memory_session_manager(session_id, user_id),
                conversation_manager=NullConversationManager(),
                system_prompt=DEFAULT_SYSTEM_PROMPT,
                tools=tools,
            )
        return cache[key]

    return get_or_create_agent
@app.entrypoint
async def invoke(payload, context):
session_id = getattr(context, "session_id", "default-session")
user_id = getattr(context, "user_id", "default-user")
agent = get_or_create_agent(session_id, user_id)
prompt = _extract_prompt(payload)
async for event in agent.stream_async(prompt):
if isinstance(event, dict) and "event" in event:
yield event按參與者和會話連線 AgentCore Memory
MEMORY_ID = os.getenv("MEMORY_BRAINAGENTMEMORY_ID")
REGION = os.getenv("AWS_REGION")


def get_memory_session_manager(session_id, actor_id):
    if not MEMORY_ID:
        return None

    session_id = session_id or uuid.uuid4().hex
    retrieval_config = {
        f"/users/{actor_id}/facts": RetrievalConfig(top_k=3, relevance_score=0.5),
        f"/users/{actor_id}/preferences": RetrievalConfig(top_k=3, relevance_score=0.5),
        f"/episodes/{actor_id}/{session_id}": RetrievalConfig(top_k=5, relevance_score=0.5),
        f"/summaries/{actor_id}": RetrievalConfig(top_k=3, relevance_score=0.5),
    }

    return AgentCoreMemorySessionManager(
        AgentCoreMemoryConfig(memory_id=MEMORY_ID, session_id=session_id, actor_id=actor_id, retrieval_config=retrieval_config),
        REGION,
    )
透過 AgentCore 資料平面呼叫專家
def _invoke_sub_agent_runtime(runtime_arn: str, query: str) -> str:
    payload = json.dumps({"prompt": query}).encode("utf-8")
    response = runtime_client.invoke_agent_runtime(
        agentRuntimeArn=runtime_arn,
        payload=payload,
    )
    return _extract_text_from_invoke_response(response["response"].read())
calls = [
("credit_risk_manage_agent_tool", runtime_arns["credit_risk_manage"]),
("fin_model_analyst_agent_tool", runtime_arns["fin_model_analyst"]),
("credit_products_agent_tool", runtime_arns["credit_products"]),
("credit_trading_agent_tool", runtime_arns["credit_trading"]),
("credit_memo_agent_tool", runtime_arns["credit_memo"]),
]
outputs = {}
for tool_name, runtime_arn in calls:
try:
outputs[tool_name] = _invoke_sub_agent_runtime(runtime_arn, query)
except Exception as error:
outputs[tool_name] = f"Invocation failed: {error}"等五個審查都傳回後再綜合
sections = [
    "All five required sub-agent outputs:",
    f"1) credit_risk_manage_agent_tool:\n{outputs['credit_risk_manage_agent_tool']}",
    f"2) fin_model_analyst_agent_tool:\n{outputs['fin_model_analyst_agent_tool']}",
    f"3) credit_products_agent_tool:\n{outputs['credit_products_agent_tool']}",
    f"4) credit_trading_agent_tool:\n{outputs['credit_trading_agent_tool']}",
    f"5) credit_memo_agent_tool:\n{outputs['credit_memo_agent_tool']}",
    "Synthesize these five outputs in your final answer.",
]
持久化專家和 Brain Agent 證據
def _put_text_file_to_s3(file_name: str, content: str) -> None:
    s3_client.put_object(
        Bucket=output_bucket,
        Key=f"{output_prefix}/{file_name}",
        Body=content.encode("utf-8"),
        ContentType="text/plain; charset=utf-8",
    )
五個專家檔案使用同一個時間戳,Brain Agent 在綜合完成後獲得一個稍晚的時間戳。最終流程是明確的:
normalize request
→ resolve actor and session
→ invoke five specialist runtimes
→ persist five specialist outputs
→ label and inject specialist context
→ stream Brain Agent synthesis
→ persist final Brain Agent output
3. 我把記憶和實時研究視為不同的資料類別
AgentCore Memory 適合穩定上下文:交易臺偏好、反覆出現的實體、過往決策、摘要和情景。它不能替代帶有 as-of 時間戳的市場資料。
● 語義記憶:用於持久事實;
● 使用者偏好記憶:用於報告風格和交易臺偏好;
● 摘要記憶:用於壓縮會話歷史;
● 情景記憶:用於過往工作流和結果。
4. 我把第三方憑證移出應用程式碼
AgentCore 專案將 EXA_API_KEY 註冊為 API 金鑰憑證提供者。執行階段中,Exa 工具會透過 AgentCore Identity 請求該憑證。這個設計避免硬編碼 key,並支援在不重新構建 Agent 包的情況下輪換憑證。
● scheduler 只能呼叫 kickoff Lambda;
● kickoff Lambda 只能呼叫 Brain Agent runtime;
● Brain Agent 只能呼叫五個具名專家 runtime,並寫入自己的 S3 字首;
● 每個 Agent 只能擷取它需要的 Exa 憑證;
● delivery Lambda 只能讀取已完成報告物件,並呼叫所需的 SES send 操作。
5. 我讓 S3 成為持久交接邊界
Brain Agent 會為每個專家以及自己的最終綜合寫入帶時間戳的 Markdown 產物。S3 不只是檔案儲存;它是機率性研究和確定性交付之間的持久邊界。
1784285928_CreditMemoAgent_output.md
1784285928_CreditProductsAgent_output.md
1784285928_CreditRiskManageAgent_output.md
1784285928_CreditTradingAgent_output.md
1784285928_FinModelAnalystAgent_output.md
1784285934_BrainAgent_output.md
S3 notification 必須專門過濾 _BrainAgent_output.md 字尾;否則每個專家產物都可能觸發一封郵件。為實現冪等性,delivery Lambda 應從 S3 object version 派生 key。
6. 我把 AI 當作加速器,而不是最終審閱者
- 將專家領域知識直接嵌入每個系統提示詞;
- 新增 Exa、Tavily 和推理工具;
- 將設定的最大輸出從 4,000 token 提高到 10,000 token,解決模型輸出截斷問題;
- 用 AgentCore Identity 註冊 Exa 憑證;
- 從 Brain Agent 委派給全部五個執行階段;
- 將本機輸出檔案替換為帶時間戳的 S3 產物。
AI 在六個相似 Agent 包之間做機械傳播、起草領域檢查清單時很有效;生成很快,但保證仍然是工程工作。
使用的 AWS 服務 / 架構概覽
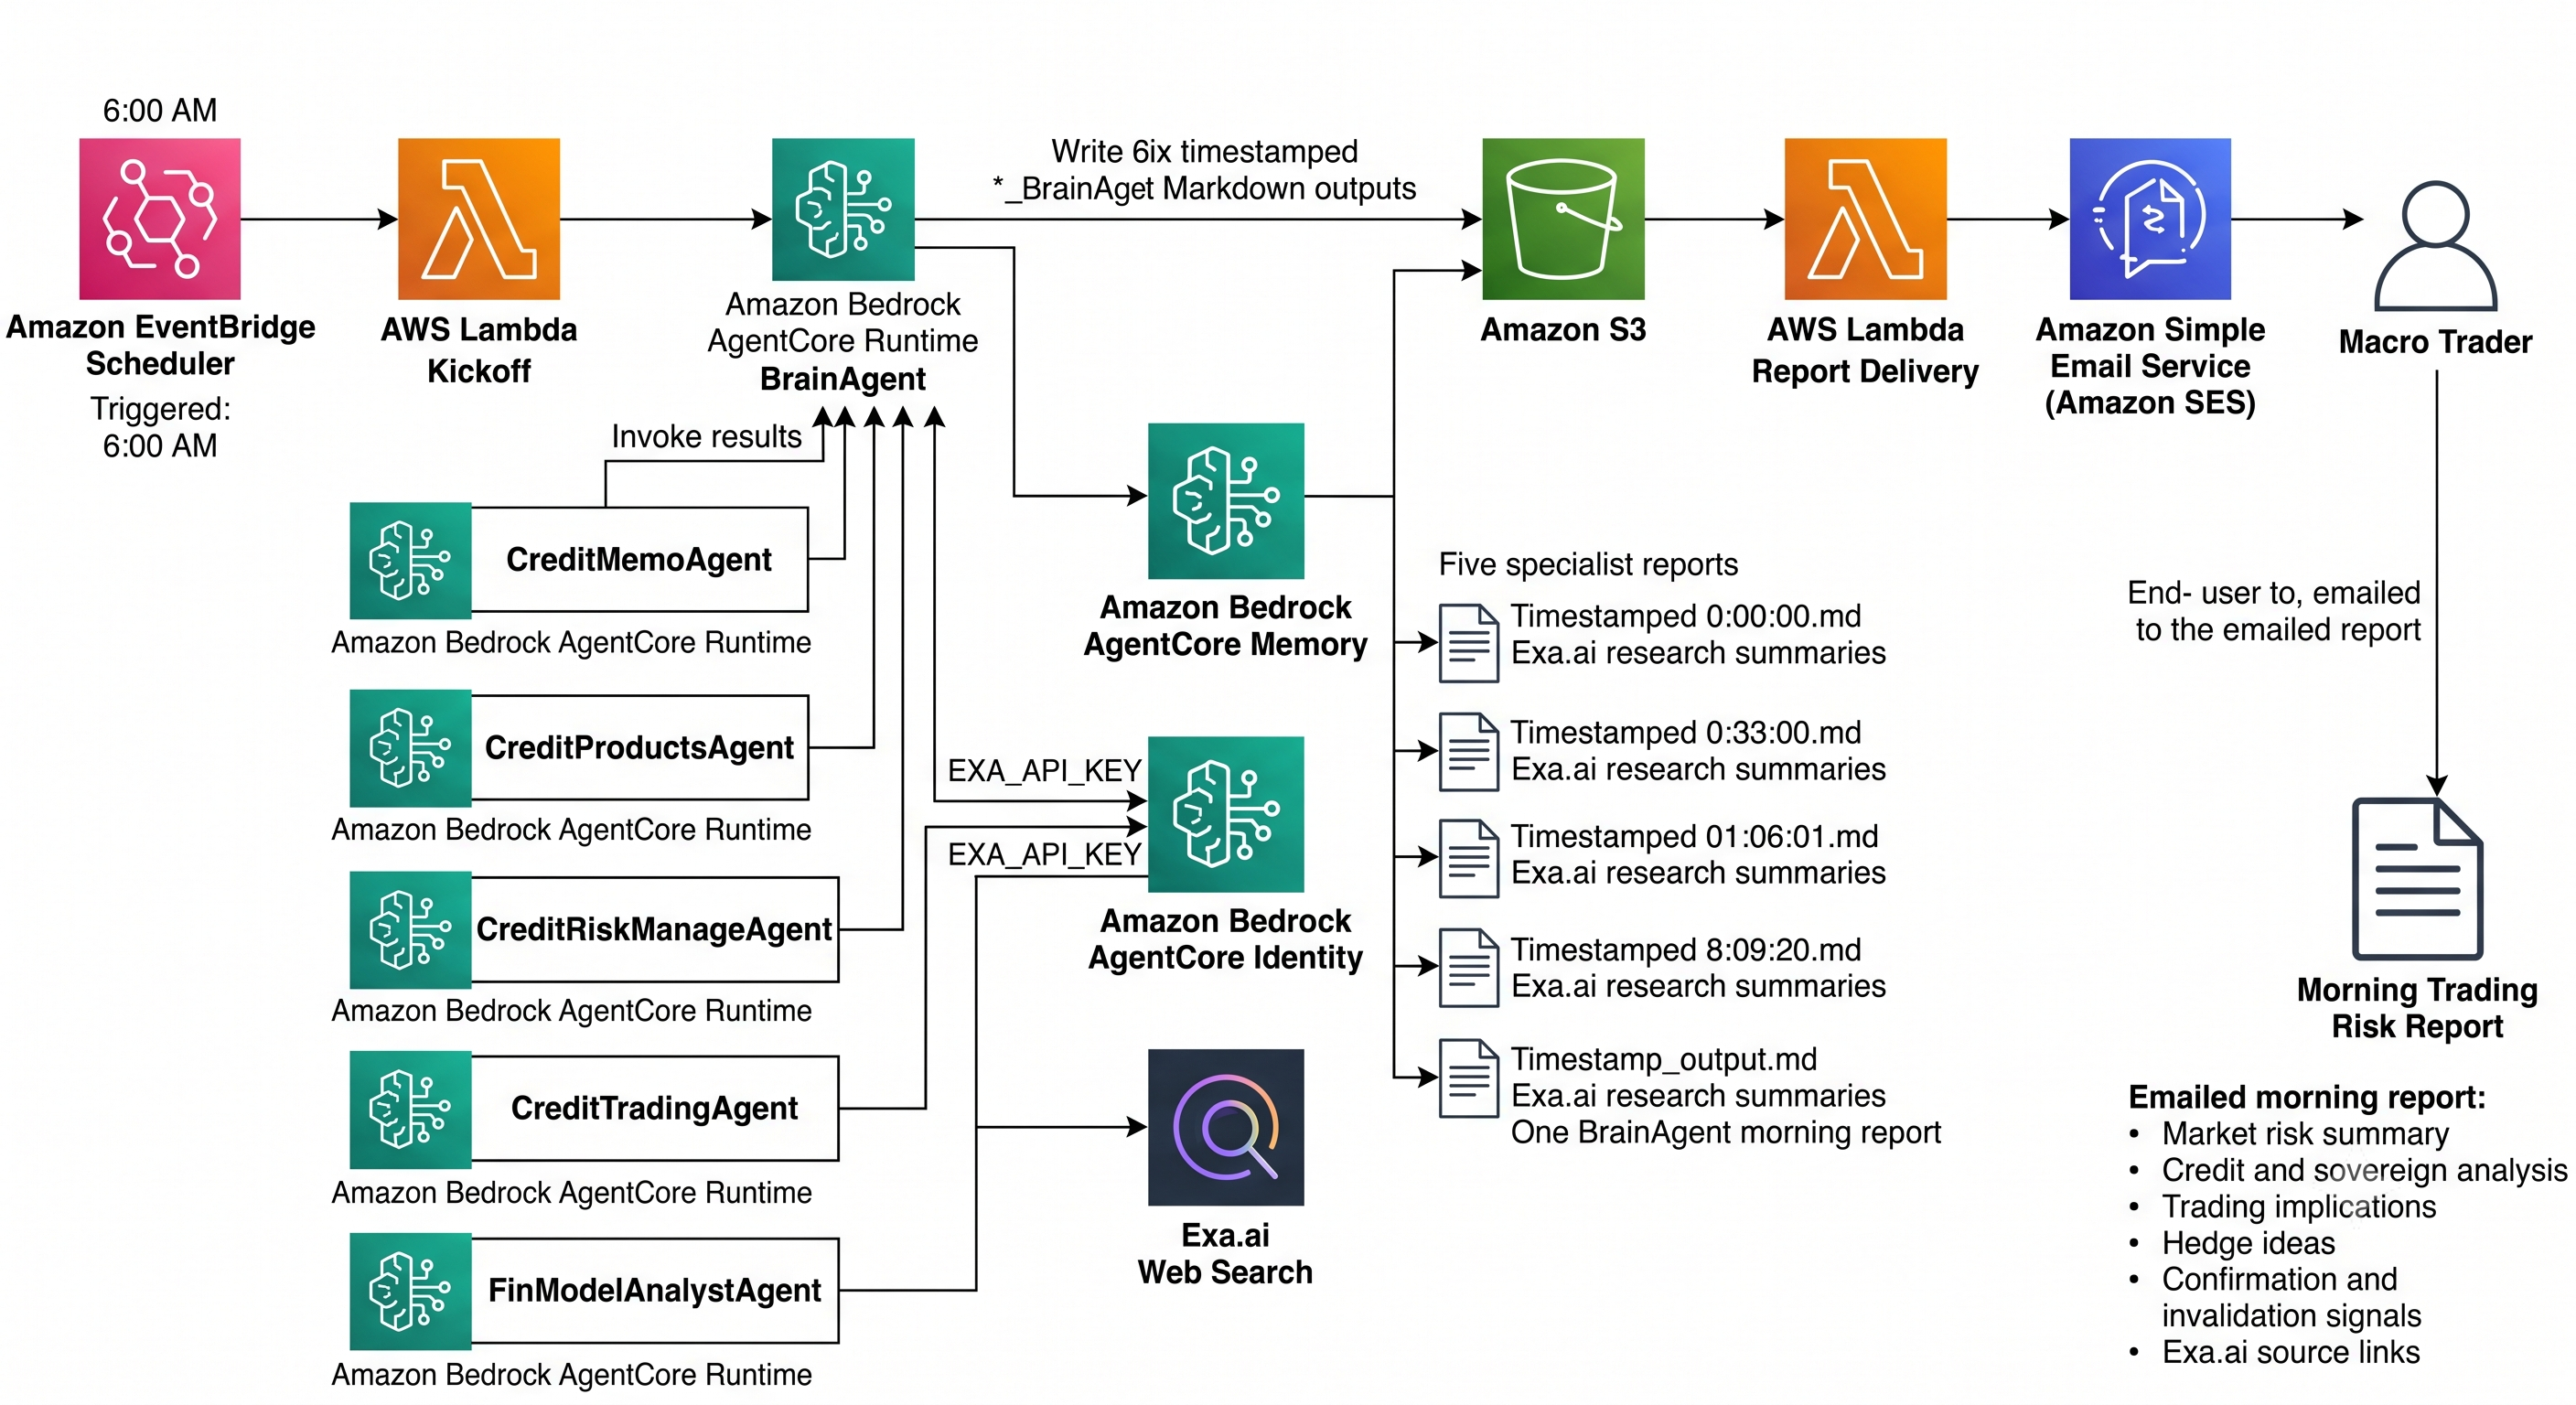
架構
概覽
Amazon EventBridge Scheduler
標籤:“6:00 AM”
→ AWS Lambda
標籤:“Kickoff”
→ Amazon Bedrock AgentCore Runtime
標籤:“BrainAgent”
BrainAgent 呼叫五個並行的 Amazon Bedrock AgentCore Runtime Agent:
● CreditMemoAgent
● CreditProductsAgent
● CreditRiskManageAgent
● CreditTradingAgent
● FinModelAnalystAgent
將 BrainAgent 和全部五個 Agent 連線到 Amazon Bedrock AgentCore Memory、Amazon Bedrock AgentCore Identity 和 Exa.ai Web Search,並將 AgentCore Identity 連線標註為 “EXA_API_KEY”。
BrainAgent 將六個帶時間戳的 Markdown 輸出寫入 Amazon S3:五份專家報告和一份 BrainAgent 晨間報告,包含 Exa.ai 研究和來源連結。
Amazon S3 → “ObjectCreated: *_BrainAgent_output.md” → AWS Lambda(報告傳送)→ Amazon Simple Email Service(Amazon SES)→ Macro Trader → 晨間交易風險報告。
步驟 1 — EventBridge Scheduler 啟動無人值守的早上 6 點執行
Amazon EventBridge Scheduler 是系統時鐘。在宏觀交易臺設定的時區 06:00,它會用一個穩定的早間審查請求呼叫 kickoff Lambda。
{
  "reportType": "morning-trading-risk-review",
  "asOf": "scheduled-invocation-time",
  "prompt": "Analyze the overnight macro, sovereign, credit, FX, commodity, liquidity, and policy-risk regime. Produce position implications, hedges, confirmation signals, and invalidation triggers."
}
排程負責時間、重試策略和死信處理。使用明確的排程時區,可以防止倫敦、紐約、香港或東京交易臺的報告在 UTC 偏移變化時發生漂移。
步驟 2 — kickoff Lambda 只呼叫 Brain Agent
kickoff Lambda 是 EventBridge Scheduler 和 AgentCore Runtime 之間的薄介面卡。它驗證定時 payload,建立 correlation 或 run ID,並用 InvokeAgentRuntime 呼叫 Brain Agent。
response = agentcore_client.invoke_agent_runtime(
    agentRuntimeArn=brain_agent_runtime_arn,
    payload=json.dumps({"prompt": morning_review_prompt}).encode("utf-8"),
)
它不呼叫 Exa,不執行專家提示詞,不寫報告,也不發郵件。
步驟 3 — BrainAgent 編排五個專家 AgentCore 執行階段
BrainAgent
├── CreditRiskManageAgent
├── FinModelAnalystAgent
├── CreditProductsAgent
├── CreditTradingAgent
└── CreditMemoAgent- CreditRiskManageAgent 透過 PD、LGD、EAD、預期損失、評級遷移、集中度、限額和契約來量化借款人和組合風險。
- FinModelAnalystAgent 透過標準化現金流、槓桿、流動性跑道、償債能力、蒙特卡洛情景和反向壓力測試來檢驗還款能力。
- CreditProductsAgent 評估融資結構、抵押品、擔保、受償順位、CDS 機制、交易對手敞口、適當性和剩餘產品風險。
- CreditTradingAgent 在考慮 carry、融資、流動性、交易成本、現券/CDS 基差、對沖規模和執行風險之後,將市場觀點轉化為候選表達方式。
- CreditMemoAgent 將證據、衝突事實、風險、緩釋因素、例外、條件和來源鏈路組織成可供審閱的記錄。
當前演示會按確定順序呼叫這些執行階段。若某次呼叫失敗,失敗會作為明確結果保留下來,而不是被靜默省略。
步驟 4 — 每個 Agent 結合提示詞、記憶、身分和當前 Exa 研究
Specialist system prompt
        +
AgentCore Memory
        +
AgentCore Identity credential
        +
Current Exa.ai web evidence
        =
Evidence-backed specialist output專家提示詞:每個 main.py 都包含領域特定的 DEFAULT_SYSTEM_PROMPT。Memory:按 actor 和 session 限定範圍的名稱空間會檢索語義事實、報告偏好、會話摘要和相關情景。Identity:EXA_API_KEY 保持在原始碼和提示詞之外。網頁搜尋:Strands 工具集包含 Exa,用於當前公開網頁研究。
輸出必須區分附有 URL 和時間的來源事實、模型推斷、風險判斷,以及需要人工核准的擬議行動。
步驟 5 — Agent 輸出和 Exa 派生研究被持久化到 S3
agent research completed
→ specialist artifacts stored
→ Brain Agent synthesis stored
→ final-report object event emitted
→ delivery begins
S3 是工作流的持久交接點:郵件失敗不需要重新執行昂貴的市場研究,報告可以從不可變的 S3 物件中安全地重新傳送。
步驟 6 — 最終 S3 物件觸發 Lambda 和 SES 交付
_BrainAgent_output.md

S3 ObjectCreated
→ validate final-report key
→ check object-version idempotency
→ read Brain Agent report
→ format email
→ send through SES
→ record delivery result
S3 event notification 和 Lambda retry 提供的是至少一次傳送,而不是 exactly-once delivery。因此,Lambda 在呼叫 SES 前必須使用 S3 object version 或另一個持久冪等 key。
● 隔夜風險環境摘要;
● 主權利率、信用、外匯、大宗商品和流動性觀察;
● 專家分歧和置信度限制;
● 組合和產品影響;
● 候選對沖或倉位調整;
● 確認訊號和失效觸發條件;
● 來源連結和 as-of 時間戳;
● 明確說明交易和信用行動需要授權的人工核准。
服務職責
Amazon EventBridge Scheduler 負責 06:00 觸發,並設定重試策略和死信佇列。AWS Lambda 建立 run ID、組裝請求並處理交付,不應包含 Agent 邏輯。Amazon Bedrock AgentCore Runtime 託管 Brain Agent 和五個專家 Agent。AgentCore Identity 儲存並代理 Exa API 金鑰憑證。AgentCore Memory 提供 session-aware retrieval。Amazon S3 儲存不可變研究產物並作為完成事件來源。Amazon SES 從已驗證身分傳送最終報告。
正式上線前我會要求的運營控制
● 執行級截止時間,防止遲到報告偽裝成當前報告。
● 針對排程缺失、Lambda 錯誤、AgentCore 呼叫失敗、不完整 manifest 和 SES 拒收的 CloudWatch 告警。
● 從 Scheduler 到 Lambda、全部六個執行階段、S3 metadata 和郵件主題傳遞 correlation ID。
● Reserved concurrency 或其他重疊保護。
● 報告中明確來源時間戳和 stale-data 警告。
● S3 事件過濾加冪等郵件交付。
● 提示詞和模型版本控制。
● 在公開網頁查詢前進行脫敏和分類控制。
● 對交易、限額、信用決策和外部分發進行人工核准。
已實現核心與交付整合的區別
當前儲存庫包含六個 AgentCore 執行階段、專家提示詞、memory 定義、Exa 工具設定、執行階段到執行階段的編排,以及 S3 輸出邏輯。EventBridge Scheduler、kickoff Lambda、S3 觸發的 delivery Lambda 和 SES 資源是本架構中描述的外圍事件驅動整合,應在稱其為完整工作流部署之前,以基礎設施即程式碼方式新增。這個區分是有意的。
你學到了什麼
多 Agent 的價值來自分歧,而不是數量
五個 Agent 重複同一份市場摘要只會放大成本和信心。真正有用的設計給每個 Agent 一個不同職責,並要求 Brain Agent 暴露分歧。
金融提示詞需要決策邊界
只有領域詞彙並不等於專業能力。強提示詞會定義決策、必需證據、公式、失敗模式和許可權邊界。
晨間簡報是一個有截止時間的系統
到了上午 10 點,一份完美的早上 6 點報告可能已經毫無價值。延遲預算、超時行為、過期資料標籤、部分結果策略和交付告警都是產品需求,而不是運營潤色。
事件驅動不等於 exactly once
Scheduler retry、Lambda retry、AgentCore failure 和重複 S3 notification 都是正常的分散式系統行為。Run ID、manifest、object version 和冪等交付可以把這些現實轉化為受控結果。
Memory 不是真相
Memory 改善連續性,但當前市場陳述仍然需要新鮮來源和時間戳。長期偏好和短期價格需要不同的保留、檢索和驗證規則。
Identity 是工具設計的一部分
連線一個網頁搜尋工具很容易。讓它在不洩露憑證、不過度授予 IAM 許可權、也不把輪換變成部署事件的情況下連線,才是真正的工程任務。
AI 開發仍然需要對抗式審查
AI 縮短了實現時間,也很容易生成看起來完整、但可靠性和安全問題尚未回答的程式碼。資深工程判斷要反覆追問:重試時會發生什麼?事實來源是什麼?哪個宣告尚未驗證?誰被授權採取行動?